
Constructiebewaking: stadion G. Meazza
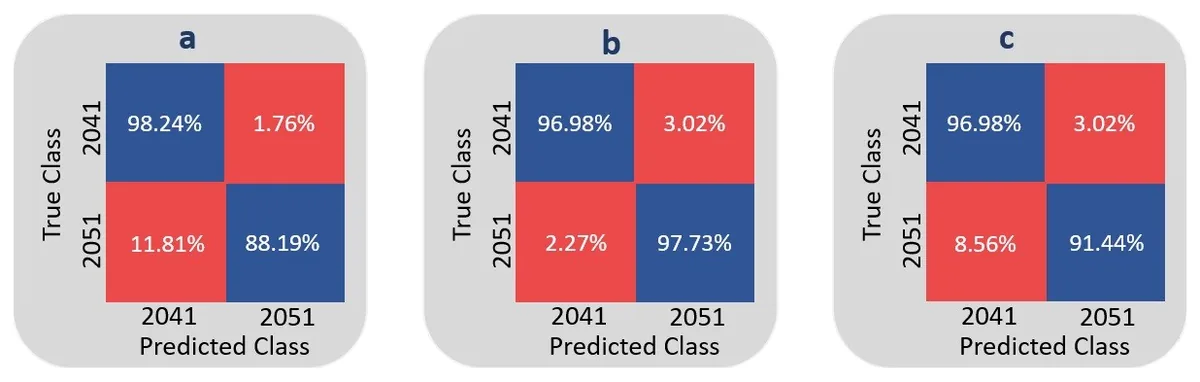
Het doel was tijdig te waarschuwen bij schade aan de tribunes van het G. Meazza-stadion in Milaan: een classificatiemodel, getraind op twee jaar trillingsmetingen, onderscheidt een gezond tribunevak van een vrijwel identiek naastgelegen vak dat de beschadigde toestand vertegenwoordigt, met 97% nauwkeurigheid op metingen die het nooit eerder had gezien. Het is ontworpen als kern van een realtime waarschuwingssysteem en mist 2,27% van de nagebootste schadegevallen, met 3,02% vals alarm.
- Project
- Afstudeerproject (M.Sc.)
- Instelling
- Politecnico di Milano
- Locatie
- Stadion Giuseppe Meazza, Milaan
- Mijn rol
- Signaalverwerking, kenmerkselectie, ontwerp en validatie van het classificatiemodel
- Software
- MATLAB (Signal Processing, Statistics & ML Toolboxes)
- 97%classificatienauwkeurigheid op 397 metingen die het model nooit had gezien
- 2,27%percentage gemiste detecties (schade aangezien voor gezond)
- 3,02%percentage vals alarm (gezond aangezien voor beschadigd)
- 4.000metingen van 10 minuten, medio 2018 tot medio 2020
Aangetoonde vaardigheden
Aanpak
Grote constructies verouderen, worden langer gebruikt dan hun oorspronkelijke ontwerplevensduur en krijgen belastingen te verwerken waarvoor ze nooit zijn gedimensioneerd, zoals concerten bovenop voetbalwedstrijden. Handmatige inspectie kan dat niet bijhouden. Het doel was een geautomatiseerd, op sensoren gebaseerd systeem dat een verandering in het constructieve gedrag signaleert zodra die in de trillingsdata zichtbaar wordt, zonder een volledig analytisch model van de constructie nodig te hebben.
- Een verandering in het constructieve gedrag automatisch detecteren uit data die op de locatie al worden verzameld, zonder het normale gebruik te onderbreken.
- Een meting in realtime als gezond of afwijkend classificeren, snel genoeg voor een live bewakingssysteem in plaats van een achteraf opgesteld rapport.
- Niet afhankelijk zijn van een eindige-elementenmodel van de hele constructie, dat onpraktisch is om te bouwen en actueel te houden voor een constructie die sinds 1925 meermaals is uitgebreid en aangepast.
- De methode valideren met echte meetdata op ware schaal, niet met een laboratoriumproefstuk of een simulatie.
- Een classificatienauwkeurigheid bereiken die betrouwbaar genoeg is om uitbreiding van de methode naar de rest van het meetnet te rechtvaardigen.
-
De constructie en het meetnet
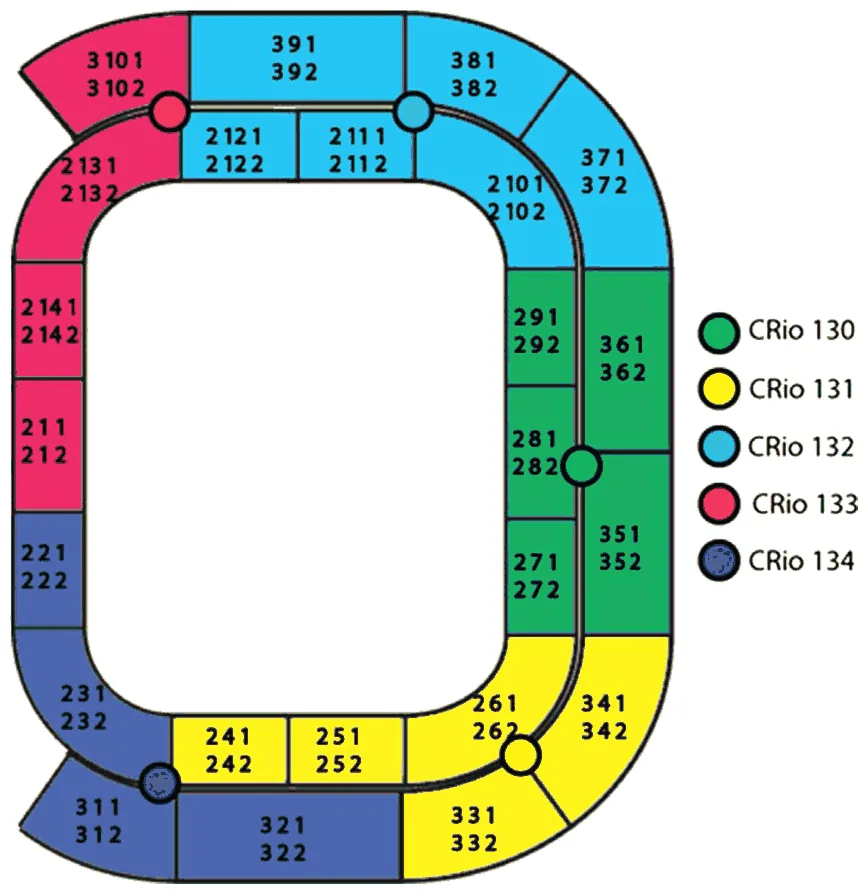
Permanent netwerk van versnellingsopnemers · 5 CompactRIO-eenheden
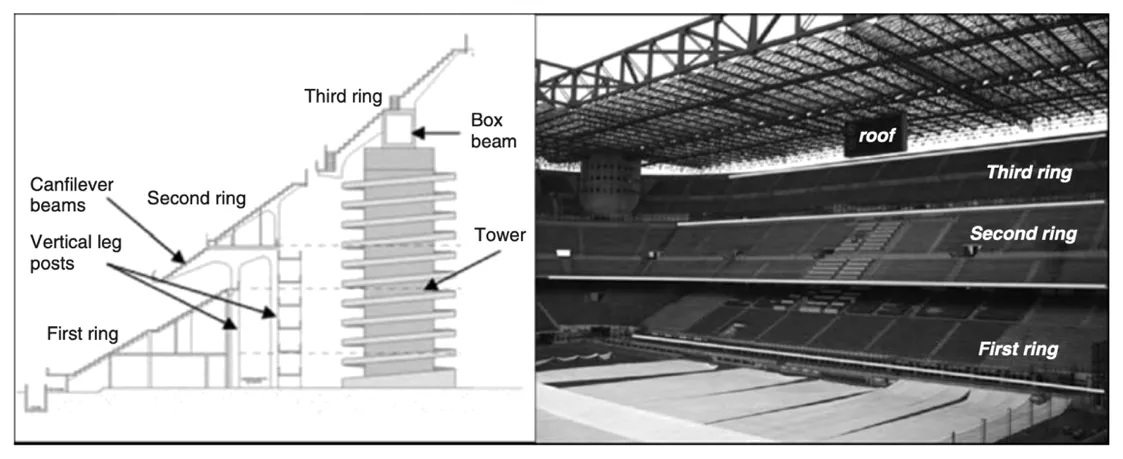
San Siro is het grootste stadion van Italië en constructief een van de meest complexe: drie tribuneringen, elk uit een andere periode en met een ander constructiesysteem, plus een onafhankelijk ondersteund dak met een eigen krachtenpad.
- Zitplaatsen
- 75.817, het grootste stadion van Italië
- Constructieve ringen
- 3, elk uit een andere periode en met een ander systeem
- Versnellingsopnemers per bewaakt tribunevak
- 2 (verticaal + horizontaal)
- Gebruikte trillingsdata
- 2018–20
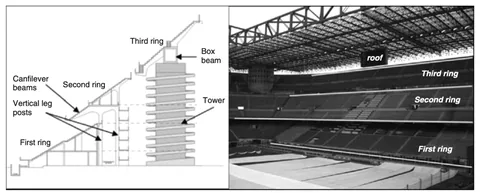
Doorsnede en foto van de eerste, tweede en derde constructieve ring, elk gebouwd in een andere bouwfase en met een eigen krachtenpad. Selecteer om te vergroten. 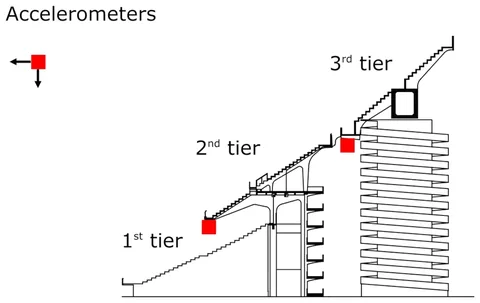
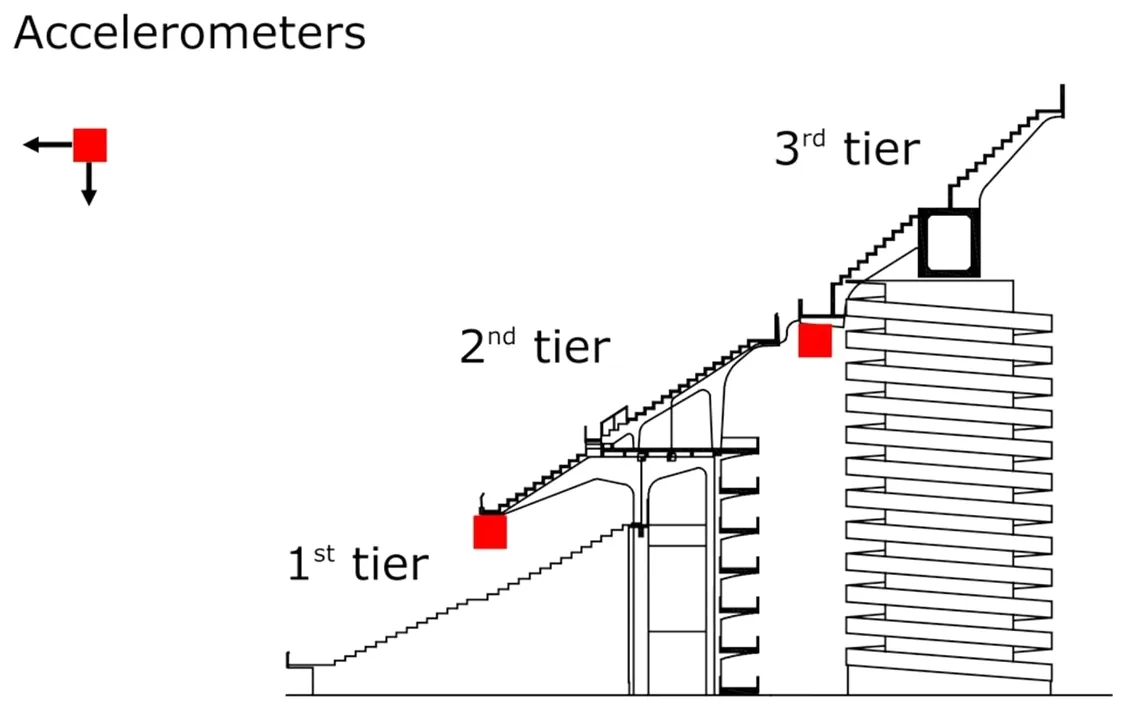
Plaatsing van de versnellingsopnemers op de eerste, tweede en derde ring. 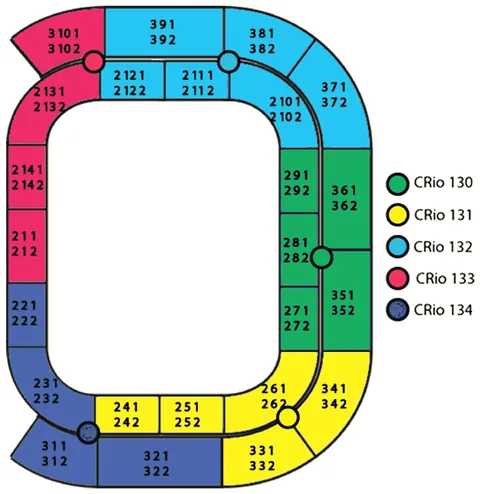
Indeling van het permanente meetnet: vijf CompactRIO-acquisitie-eenheden van National Instruments, die elk een kleurgecodeerde zone van tribunevakken bestrijken. Selecteer om te vergroten. -
Methode
MATLAB · trillingskenmerken + gesuperviseerd classificatiemodel
In plaats van de hele constructie te modelleren, vergelijkt de aanpak nieuwe trillingsmetingen met een bekende referentietoestand. Conceptueel is dat hetzelfde als een modale analyse in FEA, waarin een verschuiving van eigenfrequentie of eigenvorm ten opzichte van een referentiemodel als schade wordt geïnterpreteerd. Hier is de referentie een echt, gezond tribunevak in plaats van een gezond FE-model.
Classificatie = classificatiemodel (27 uit trillingen afgeleide kenmerken, bepaald uit een meting van 10 minuten met de versnellingsopnemers)
- Twee versnellingsopnemers (verticaal + horizontaal) per tribunevak voeden een permanent, bekabeld meetnet dat met 128 Hz bemonstert.
- Tribunevak 2041 dient als gezonde referentie; een constructief vergelijkbaar naastgelegen vak, 2051, staat voor het beschadigde geval. Dat is bewust de moeilijkst mogelijke vergelijking, omdat de twee vakken zich onder normale belasting vrijwel identiek gedragen.
- Per meting worden 27 kenmerken bepaald: spectrale kenmerken die gevoelig zijn voor veranderingen in stijfheid en massa, en statistische kenmerken die gevoelig zijn voor kleinere veranderingen die de spectrale kenmerken missen.
- Een classificatiemodel wordt getraind op 70% van de dataset, gevalideerd op de overige 30% en daarna zwaar op de proef gesteld met metingen die het tijdens training en afstemming nooit heeft gezien.
- Kenmerkextractie, training van het classificatiemodel, optimalisatie en codegeneratie voor de implementatie zijn volledig in MATLAB uitgevoerd.
Wie ooit een modale analyse in FEA heeft uitgevoerd, heeft al een versie hiervan gedaan: de stijfheid of massa van een model veranderen, zien hoe de eigenfrequenties en eigenvormen verschuiven en die verschuiving als schade interpreteren. Dit project past dezelfde logica toe op een echte constructie, met sensordata in plaats van het FE-model.
Dezelfde logica als een modale schadecontrole in FEA In een modale FEA-studie In dit project Het FE-model van het gezonde onderdeel of de gezonde constructie opbouwen. Twee echte, vrijwel identieke tribunevakken staan voor het gezonde en het beschadigde model. Een verandering in stijfheid of massa aanbrengen om schade weer te geven. Versnellingsopnemers vervangen de FE-solver als bron van dynamische gegevens. De modale analyse opnieuw uitvoeren. Er worden 27 kenmerken bepaald, waaronder een aantal van dezelfde modale grootheden die in een FEA-rapport zouden staan: dominante frequentie, frequentieverhouding, spectrale entropie. Eigenfrequenties en eigenvormen vergelijken met de referentie. Een getraind classificatiemodel vervangt de handmatige vergelijking van eigenvormen. Een verschuiving buiten de tolerantie duidt op schade. Een afwijking van de gezonde referentie duidt op schade, in realtime en op echte data. -
Technisch proces
Kenmerkselectie → vergelijking van classificatiemodellen → afstemming → blinde test
Vier stappen, die elk verder toewerken naar een betrouwbaar realtime classificatiemodel, plus één bewuste stap terug van het “beste” validatieresultaat toen dat niet meer bleek te generaliseren.
De stap terug van de beste validatiescore naar de beste testscore was een bewuste keuze: minder iteraties voorkwamen overfitting op de trainingsdata en generaliseerden beter naar data die het model werkelijk nooit had gezien. Omdat de resultaten van de blinde test die keuze hebben gestuurd, moet de 97% vóór ingebruikname worden bevestigd op een nieuwe, onafhankelijke testset (zie de aanbevelingen).
- 1. Kenmerkselectie
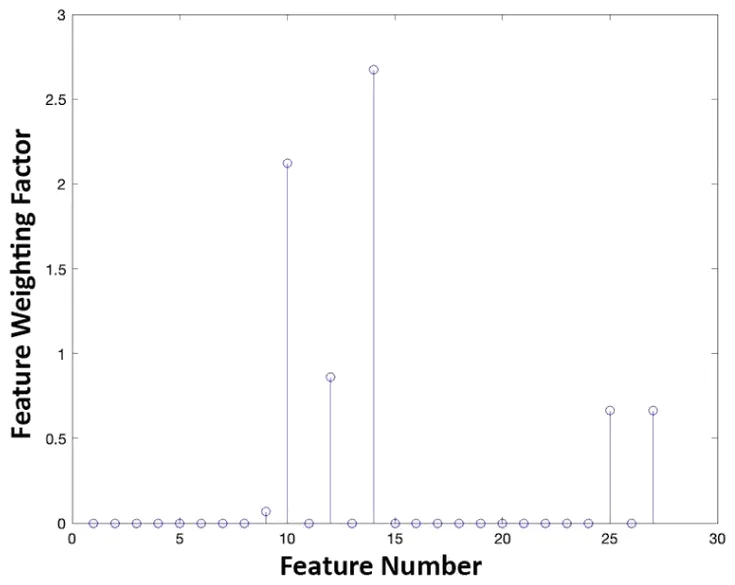
- Alle 27 kenmerken behouden: 86,2% tegenover 78,1% (5 NCA) en 80,2% (7 hybride)
- 2. Keuze van het classificatiemodel
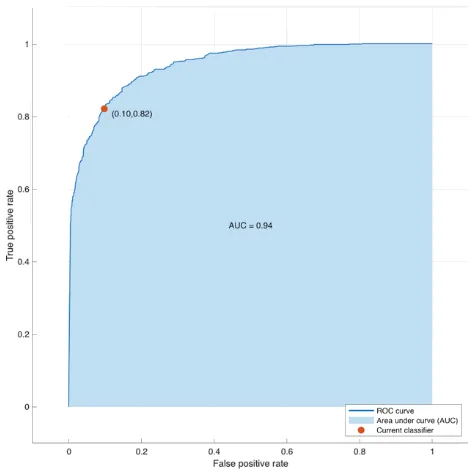
- Boosted Trees Ensemble, de beste van 30: 86,3%, AUC 0,94
- 3. Kostenverhouding en afstemming
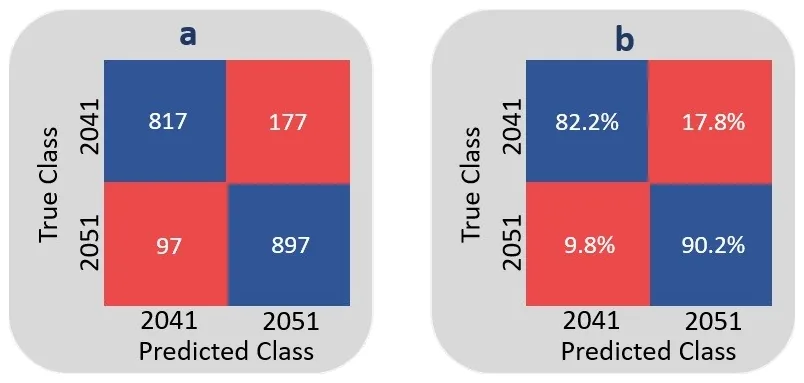
- Kostenverhouding 5 : 3; vals alarm 17,8% → 12,6%
- 4. Onafhankelijke blinde test
- 8 iteraties, niet 14: 2,27% / 3,02% fouten
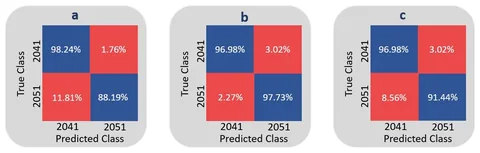
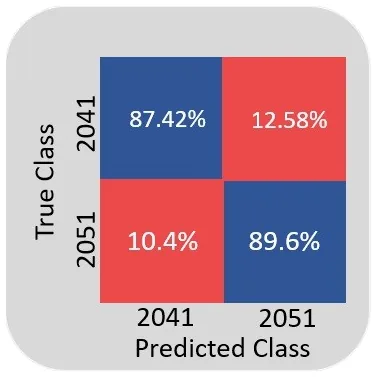
Confusiematrices van de blinde test bij de 4e (a), 8e (b) en 14e (c) zoekiteratie. Met 8 iteraties is het resultaat het best en het meest evenwichtig. Selecteer om te vergroten. Elke stap staat, met de bijbehorende figuren, volledig in de technische details.
Controle van de resultaten
Het geoptimaliseerde classificatiemodel haalt 97% nauwkeurigheid op data die het tijdens training en afstemming nooit heeft gezien, met beide soorten fouten laag genoeg om een echt bewakingssysteem op te vertrouwen.
97%
classificatienauwkeurigheid op de onafhankelijke blinde testset (397 nieuwe metingen)
Het model onderscheidt het gezonde tribunevak correct van het vak dat schade nabootst in 97 van elke 100 nieuwe metingen: 2,27% gemiste detecties (het vak dat schade nabootst, aangezien voor gezond) en 3,02% vals alarm (gezond aangezien voor beschadigd), bereikt tussen twee constructief vrijwel identieke tribunevakken, de moeilijkste vergelijking in de dataset.
Classificatienauwkeurigheid in de loop van het technische proces
Validatie- / testnauwkeurigheid per stap, in %. Beweeg over een balk voor details.
| Controlepunt | Maatstaf | Resultaat | Status |
|---|---|---|---|
| Keuze van de kenmerkenset | Validatienauwkeurigheid, 27 kenmerken | 86,2% | Gekozen |
| Vergelijking van classificatiemodellen | Beste van 30 classificatiemodellen (Boosted Trees Ensemble) | 86,3% val., AUC 0,94 | Gekozen |
| Afstemming van kostenverhouding en hyperparameters | Percentage vals alarm (gezond → beschadigd) | 17,8% → 12,6% | Verbeterd, onbalans bleef |
| Onafhankelijke blinde test (8 iteraties) | Percentage gemiste detecties / vals alarm | 2,27% / 3,02% | Gevalideerd |
| Totaalresultaat | Definitieve classificatienauwkeurigheid, nieuwe data | 97% | Gevalideerd |
Technisch oordeel en aanbevelingen
Naast het nauwkeurigheidsgetal kwamen bij het doorlopen van deze keten enkele punten naar voren die het vermelden waard zijn voordat een dergelijke methode in een operationeel bewakingssysteem wordt ingezet.
-
Aandachtspunt
Nog geen bevestigd geval van echte schade
De beschadigde toestand is hier een vervanging: een werkelijk onbeschadigd, maar constructief afwijkend tribunevak staat voor de beschadigde toestand van vak 2041. Het classificatiemodel is nooit getest op een bevestigde echte schadegebeurtenis. Voordat het operationeel wordt ingezet, moet het worden getoetst aan gegevens over renovaties, reparaties of incidenten zodra die beschikbaar komen.
-
Aandachtspunt
De 97% bevestigen op een nieuwe, onafhankelijke testset
De resultaten van de blinde test hebben ook de definitieve instelling bepaald (8 zoekiteraties in plaats van 14), zodat dezelfde metingen zowel voor de modelkeuze als voor de eindscore zijn gebruikt. De 97% is daardoor licht optimistisch; een nieuwe, onaangeroerde set metingen, of een geneste kruisvalidatie, moet die waarde bevestigen voordat het classificatiemodel in gebruik wordt genomen.
-
Kans: uitbreiden naar verder gelegen, meer verschillende tribunevakken
De vakken 2041 en 2051 waren bewust het moeilijkste paar: naast elkaar, vrijwel identiek en gemakkelijk te verwarren. Dezelfde keten met 27 kenmerken zou gemakkelijker moeten generaliseren naar paren van vakken met een duidelijker verschillend dynamisch gedrag. Uitbreiding daarnaartoe is de logische volgende stap, met een nog hogere lat voor de nauwkeurigheid.
-
Opnieuw een referentie vastleggen na elke constructieve wijziging
De gezonde referentie is empirisch en gebaseerd op het gemeten gedrag van vak 2041 tussen 2018 en 2020. Elke toekomstige wijziging aan dat vak, of aan het krachtenpad eromheen, maakt de referentie ongeldig. Dezelfde discipline als bij het bijwerken van een FE-model na een ontwerpwijziging geldt hier: opnieuw referentiedata verzamelen en het model opnieuw trainen.
-
De kostenverhouding is voor dit paar afgestemd, niet algemeen
De kostenverhouding van 5:3 die de foutpercentages in evenwicht bracht, is door uitproberen gevonden voor dit specifieke paar tribunevakken. Bij uitrol van dezelfde keten naar andere locaties moet die verhouding worden behandeld als een parameter die opnieuw moet worden afgestemd, niet als een vaste waarde, omdat de achtergrondruis en de constructieve gelijkenis per vak verschillen.
Technische details
De samenvatting van de data en elke stap van het technische proces volledig uitgewerkt, voor wie zich verder wil verdiepen.
Samenvatting van de data Instrumentatie, meting en dataset: 128 Hz, vensters van 10 minuten, 4.000 metingen, verdeling 70/30
Twee jaar meetdata, samengebracht in een dataset die groot genoeg is om een classificatiemodel te trainen en toch een werkelijk onafhankelijke testset achter te houden.
| Parameter | Waarde |
|---|---|
| Instrumentatie | |
| Sensoren per bewaakt tribunevak | 2 (verticale + horizontale versnellingsopnemer) |
| Acquisitiehardware | 5× CompactRIO-eenheden van National Instruments |
| Bemonsteringsfrequentie | 128 Hz |
| Meting | |
| Vensterlengte | 600 s (10 min), zonder overlap |
| Excitatie | Omgevingstrillingen (leeg stadion, geen evenement) |
| Meetperiode | Medio 2018 – medio 2020 |
| Dataset | |
| Totaal aantal metingen | 4.000 |
| Verdeling training / validatie | 70% / 30% |
| Onafhankelijke blinde testset | ~397 metingen |
| Kenmerken per meting | 27 (spectraal + statistisch) |
Technisch proces: de vier stappen Kenmerkselectie, vergelijking van classificatiemodellen, afstemming van kostenverhouding en hyperparameters, onafhankelijke blinde test
Vier stappen, die elk verder toewerken naar een betrouwbaar realtime classificatiemodel. De confusiematrices van de blinde test uit de vierde stap staan in stap 3.
01. Kenmerkselectie: volledige set tegenover beperkte set
Aanpak
Minder kenmerken betekent doorgaans snellere verwerking. Daarom zijn drie kenmerkensets rechtstreeks met elkaar vergeleken: alle 27 kenmerken, 5 kenmerken gekozen met Neighborhood Component Analysis (NCA), en een hybride set van 7 kenmerken waarin twee fysisch betekenisvolle kenmerken weer zijn toegevoegd.
Een kleinere kenmerkenset verkortte de verwerkingstijd met tot 60%. Omdat de verwerking in alle scenario’s toch realtime bleef, kostte die winst voor een veiligheidsrelevante toepassing te veel nauwkeurigheid. Daarom zijn voor de rest van de studie alle 27 kenmerken behouden.
02. Keuze van het classificatiemodel: 30 modellen vergeleken
Aanpak
Er zijn 30 classificatiemodellen uit acht families (beslisbomen, SVM, ensembles, neurale netwerken en meer) getraind en gevalideerd op dezelfde kenmerkentabel om de beste aansluiting bij deze data te vinden.
Ensemblemethoden en niet-lineaire SVM presteerden het best; discriminantanalyse faalde volledig, hoogstwaarschijnlijk omdat sommige kenmerken binnen een klasse constant of lineair afhankelijk waren, waardoor de covariantiematrices per klasse singulier worden. De verwerkingstijd was over de hele linie kort genoeg, zodat de nauwkeurigheid en niet de snelheid de keuze bepaalde.
03. Optimalisatie van kostenverhouding en hyperparameters
Aanpak
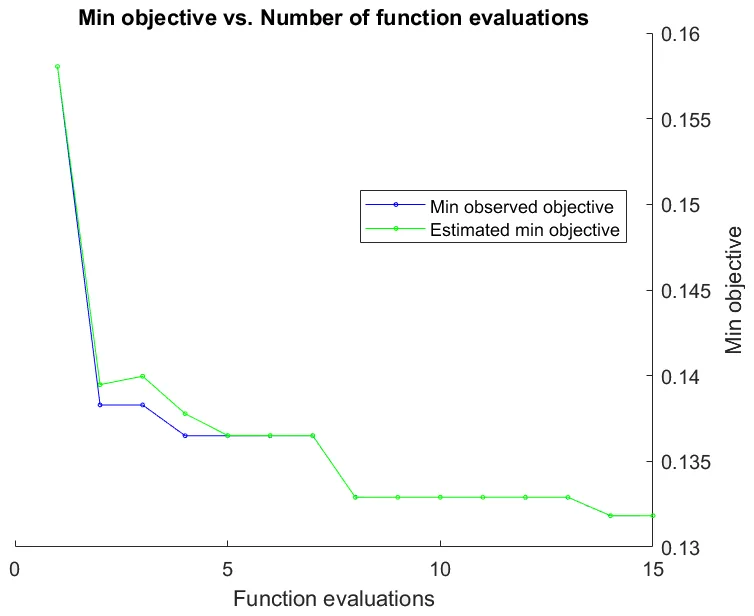
Het onbewerkte classificatiemodel gaf te vaak vals alarm voor een bewakingstoepassing (17,8% van de gezonde metingen als beschadigd geïnterpreteerd). Om dat te verhelpen zijn twee knoppen afgesteld: een kostenverhouding voor misclassificatie, die het model naar het gezonde vak laat neigen, en de hyperparameters van het model zelf, via Bayesiaanse optimalisatie.
Beste kostenverhouding = 5 : 3 | zoektocht naar hyperparameters stabiliseerde bij 14 iteraties
De afweging verbeterde de belangrijkste maatstaf, maar loste de onbalans niet volledig op: een teken dat 14 iteraties begonnen te overfitten. Precies dat moest de volgende stap aan het licht brengen.
04. Onafhankelijke blinde test: bescherming tegen overfitting
Aanpak
Het model met 14 iteraties zag er op de validatiedata het best uit, maar validatiedata bewijzen nog geen prestaties in de praktijk. Het model is opnieuw getest op ~397 metingen die het nooit had gezien, bij drie verschillende lengtes van de hyperparameterzoektocht, om na te gaan welke werkelijk het best generaliseerde.
De stap terug van de beste validatiescore naar de beste testscore was een bewuste keuze: minder iteraties voorkwamen overfitting op de trainingsdata en generaliseerden beter naar data die het model werkelijk nooit had gezien. Omdat de resultaten van de blinde test die keuze hebben gestuurd, moet de 97% vóór ingebruikname worden bevestigd op een nieuwe, onafhankelijke testset (zie de aanbevelingen).